天工超级智能体
具备DeepResearch能力的超级智能体,一键生成文档、PPT、表格,高效应对办公与学习场景。
月之暗面推出的Kimi大模型API开放平台,支持超长上下文、多模态理解与工具调用,助力开发者构建AI应用。
 Kimi Work
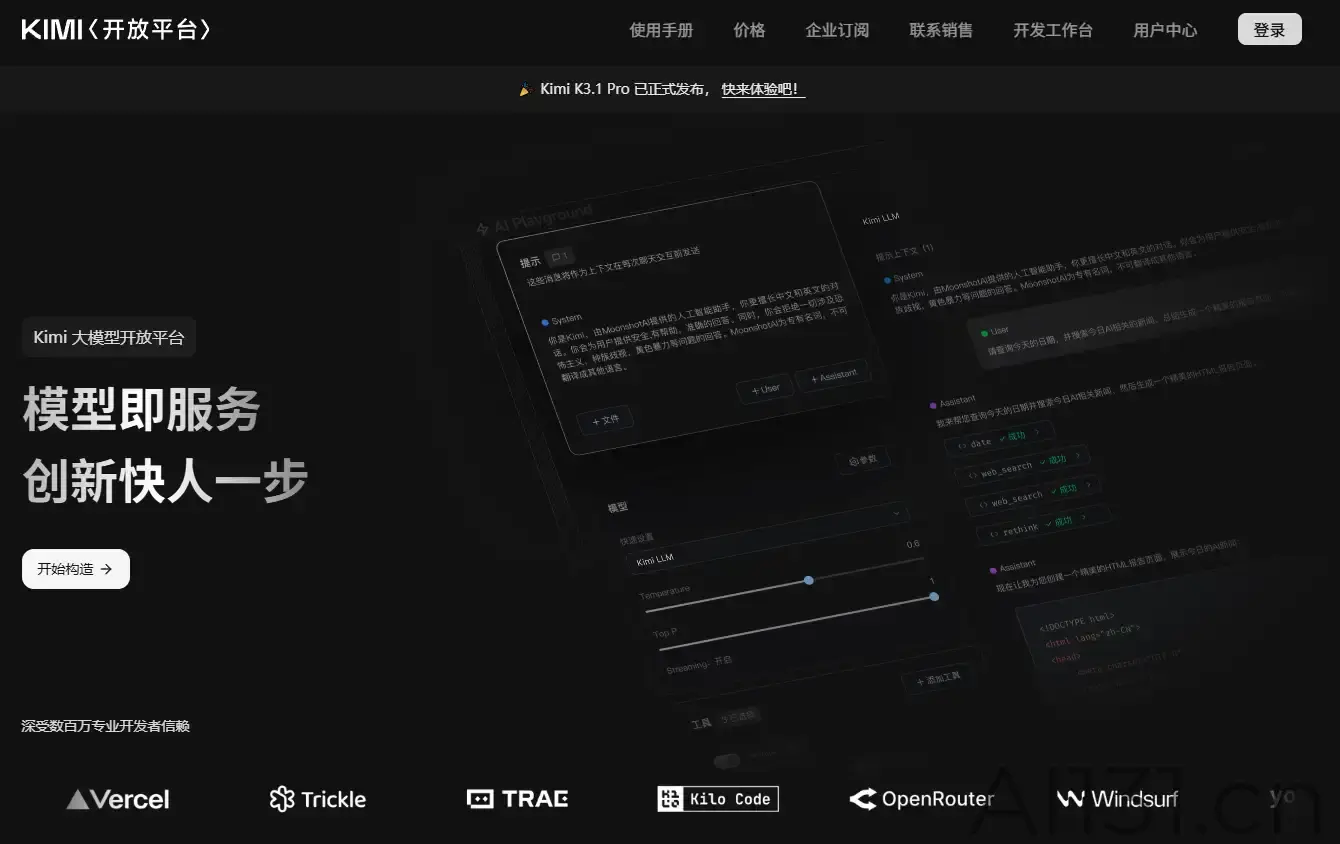
本次测评对象为月之暗面推出的 Kimi API 开放平台(platform.kimi.com)。测评目的是判断该平台在真实开发场景中的可用性,包括模型能力、接入体验、稳定性与定价合理性,帮助开发者在选型时做出明确判断。
推荐等级:B+(值得接入,但有明确边界)
适合需要长上下文处理、文档理解与工具调用的应用;不适合对推理成本极度敏感或需要成熟多模态生态的团队。
平台围绕 Kimi 系列模型提供 API 服务,核心能力集中在三块:
| 能力 | 具体表现 | 适用场景 |
|---|---|---|
| 超长上下文 | 支持数十万至百万级 token 输入 | 长文档分析、代码库理解、会议记录汇总 |
| 多模态理解 | 支持图像输入并参与推理 | 票据识别、图表解读、截图问答 |
| 工具调用 | 支持 Function Calling 与结构化输出 | Agent 编排、外部数据检索、流程自动化 |
实测中,长上下文是其最突出的差异点:输入一份数百页的技术文档后提问细节,模型能定位到具体章节并给出引用位置,而非泛泛复述。工具调用的参数格式基本稳定,配合 JSON Schema 可减少解析失败。
优点
缺点
适合谁:做长文档问答、知识库检索增强、合同/报告分析、代码理解类产品的团队;已有 OpenAI 风格架构、希望快速切换或补充国产模型的开发者。
不适合谁:高频短请求、对单价极度敏感的 C 端应用;需要成熟多模态视频理解或复杂视觉 Agent 的项目,建议同时评估其他多模态更强的平台作为补充。
替代建议:若核心诉求是低成本高并发短文本,可对比同价位轻量模型;若强依赖视觉与生态工具链,建议保留国际主流模型作为主通道,Kimi 作为长上下文场景的补充。
Kimi API 和 OpenAI 接口兼容吗?
接口风格与 OpenAI 生态接近,已有项目迁移时改动量较小,存量应用切换成本低。
Kimi API 的长上下文支持多大输入?
支持数十万至百万级 token 输入,适合长文档分析、代码库理解与会议记录汇总等场景。
Kimi API 适合哪些应用场景?
长文档问答、知识库检索增强、合同/报告分析、代码理解类产品,以及需要工具调用的文档型 Agent 编排。
Kimi API 的成本和延迟如何控制?
长文本输入会显著推高 token 费用与首 token 延迟,建议做输入裁剪、分段处理,并在架构上采用流式输出与超时设计。
Kimi API 的多模态能力够用吗?
支持图像输入并参与推理,可用于票据识别、图表解读、截图问答;但复杂视觉推理覆盖面窄于头部国际模型,需实测验证。